Informação essencial sobre a nossa abordagem a dados privados de empresas
Esta página reúne, num único lugar, a forma como a Quoriseltana pensa e aplica IA a dados privados de empresas. Em vez de prometer soluções instantâneas, explicamos o nosso método de três camadas, os compromissos que assumimos com privacidade e rastreabilidade e as limitações que aceitamos por princípio. Se a sua equipa trabalha com research em venture capital ou mercados privados e está cansada de folhas de cálculo intermináveis, use esta visão como base para discutir internamente se faz sentido falar connosco com dados reais em cima da mesa.
Equipa Quoriseltana
Engenharia de dados e research em mercados privados
Visão geral
Uma visão concentrada sobre o que a nossa IA faz com dados privados de empresas, porque isso interessa às suas equipas e onde desenhamos as linhas que preferimos não cruzar.
Se trabalha com dados privados de empresas, sabe que a teoria da IA raramente coincide
com a realidade de pastas partilhadas e bases desactualizadas. Na Quoriseltana partimos dessa
fricção: aceitamos fontes imperfeitas, registamos as suas falhas e construímos pipelines
que não fingem ter visão total do mercado. Esta página reúne a visão de alto nível do
que fazemos, para quem o fazemos e que compromissos assumimos quando mexemos em
informação sensível ligada a research em venture capital e mercados privados.
Começar conversa
Quem faz isto acontecer
A nossa equipa junta engenheiros de dados, cientistas de dados e analistas de mercados privados que já passaram tempo suficiente a reconciliar folhas de cálculo para saber onde a teoria falha. Trabalhamos como um laboratório aplicado: testamos ontologias, revemos heurísticas, comparamos versões de modelos e aceitamos que parte do trabalho mais valioso é simplesmente dizer não a integrações que não fazem sentido para o caso de uso.
Mantemos uma cultura de documentação quase obsessiva, porque sabemos que research em venture
capital e mercados privados vive de explicar decisões a terceiros. Cada pipeline que
desenhamos vem acompanhado de descrições técnicas, limites conhecidos e exemplos de casos em
que o modelo se comporta pior. Não prometemos perfeição, mas esforçamo‑nos por tornar
visíveis as imperfeições, para que equipas possam decidir de forma informada como e quando
confiar nos dados gerados.
Quem trabalha com research em mercados privados sabe que as decisões raramente falham por falta de gráficos, mas sim por falta de clareza sobre o que está por trás de cada número. A info da Quoriseltana existe para reduzir essa assimetria.
Quando descrevemos a nossa abordagem à IA, começamos sempre pelos limites. Dados
privados de empresas são parciais, sujeitos a atrasos e influenciados pelos próprios
incentivos de quem os reporta. Em vez de tentar corrigir tudo de forma invisível,
registamos estas imperfeições: datas de actualização, origem, confiança atribuída e
impacto provável em métricas derivadas. Esta transparência permite que equipas de
venture capital e research decidam onde vale a pena aprofundar investigação qualitativa.
A nossa experiência mostrou que a maior parte dos ganhos não vem de modelos exóticos, mas de uma melhor disciplina na forma como entidades e eventos são definidos. Ao adoptar uma ontologia clara, extensível e documentada, reduzimos ambiguidades que antes eram resolvidas de forma ad‑hoc em folhas de cálculo. Isto não elimina a necessidade de juízo humano, mas torna mais consistente a forma como diferentes analistas falam sobre as mesmas empresas e trajectórias.
Também assumimos que a relação com dados privados de empresas é dinâmica. Novas fontes
surgem, teses de investimento mudam, equipas crescem ou se reorganizam. Por isso
desenhamos pipelines com pontos de revisão programados, em que modelos, regras de
correspondência e esquemas são reavaliados. Results may vary ao longo do tempo, e
queremos que essa variação seja explicável, não um artefacto opaco de código esquecido.
O que pode esperar da Quoriseltana se decidir explorar connosco um projecto de dados privados de
empresas.
O que fazemos, o que não fazemos e o que isso implica
Esta secção destina‑se a quem precisa de alinhar expectativas internas antes de avançar para uma conversa connosco. Não é uma proposta comercial, é um mapa das perguntas que achamos saudáveis quando se fala de IA aplicada a dados privados de empresas.
Primeiro, clarificamos o que não fazemos: não oferecemos decisões automáticas sobre investimento, não assumimos funções de aconselhamento regulado e não prometemos trajectórias de desempenho. O nosso foco está em processar, ligar e enriquecer dados privados de empresas para suportar research, sabendo que a responsabilidade final pelas decisões continua nas equipas que os utilizam. Past performance doesn't guarantee future results, e qualquer análise baseada nos nossos outputs deve ser complementada com validação independente.
Depois, discutimos abertamente trade‑offs entre granularidade e privacidade. Mais detalhe
nem sempre significa melhor decisão, sobretudo quando implica recolher ou reter dados cuja
utilidade marginal é baixa. Trabalhamos com clientes para definir o nível de detalhe
adequado a cada caso de uso, aceitando que, em alguns contextos, é preferível trabalhar com
agregados ou com janelas temporais mais curtas para reduzir exposição desnecessária.
Por fim, falamos de governança e de manutenção. Um pipeline de IA sobre dados privados de
empresas não é um projecto que se encerra após a implementação inicial. Exige revisões
periódicas, monitorização de qualidade e, por vezes, reprocessamento de históricos. Results
may vary precisamente porque mercados, fontes e equipas mudam. O que propomos é uma forma
disciplinada de lidar com essa mudança, em vez de fingir estabilidade onde ela não existe.
Da realidade dos dados brutos às bases utilizáveis
Esta página existe para quem precisa de mais do que slogans sobre IA. Se está a avaliar se a
Quoriseltana faz sentido para a sua equipa, provavelmente quer ver como traduzimos ceticismo em
arquitectura concreta, que tipos de problemas resolvemos e que compromissos metodológicos
assumimos desde o início.
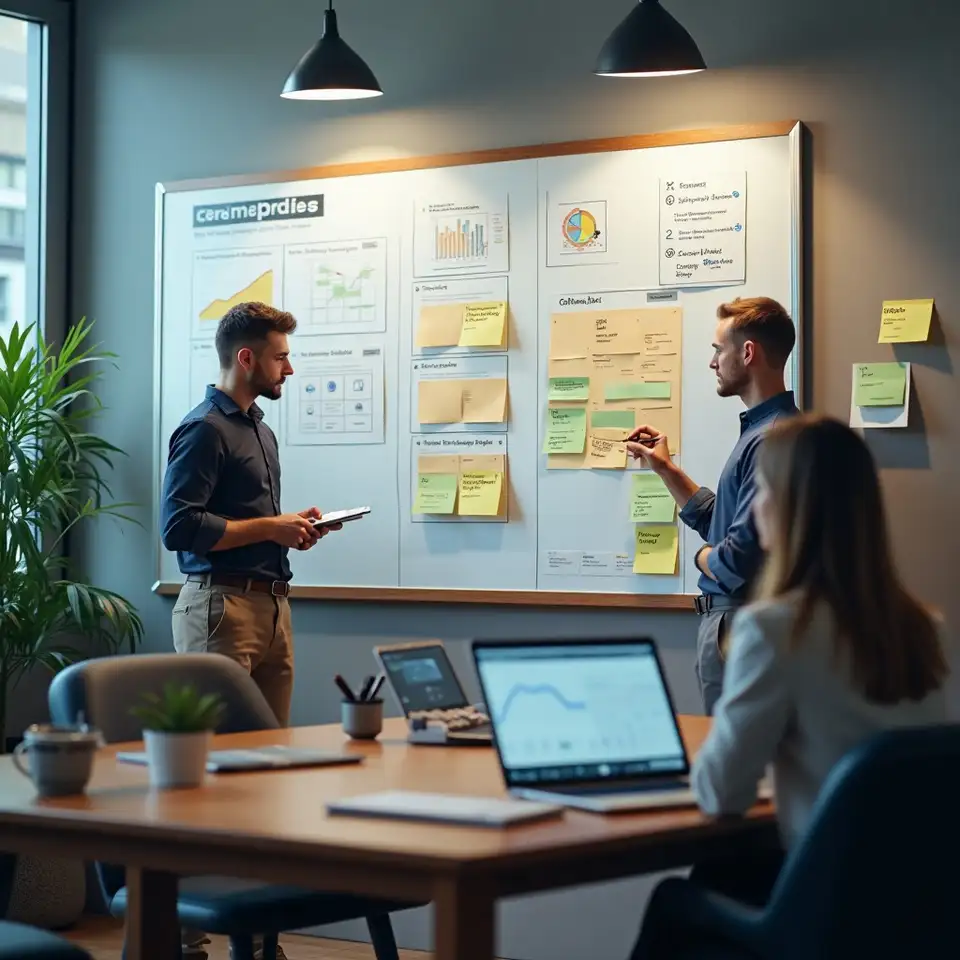
Mapeamento e desenho inicial
Antes de qualquer modelo, conduzimos uma fase de mapeamento em que identificamos sistemas internos, bases externas, documentos chave e notas de analistas. O objectivo é construir um diagrama claro de onde vivem hoje os dados privados de empresas e como circulam entre equipas. Só depois desenhamos o pipeline de IA, respeitando fluxos existentes e limitações operacionais, em vez de impor uma arquitectura abstracta desligada da prática diária.
Grafo como estrutura central
Com o terreno mapeado, construímos um grafo de entidades e eventos que serve de espinha dorsal para todo o enriquecimento. Empresas, pessoas, rondas, contratos e outros marcos relevantes passam a ser nós e ligações com atributos claros. A IA ajuda a propor correspondências e a preencher lacunas, mas mantemos scores de confiança e versões históricas, para que analistas possam ver onde a estrutura é sólida e onde ainda assenta em hipóteses mais frágeis.
Camadas de consumo e revisão contínua
Finalmente, expomos o resultado em camadas adaptadas a diferentes perfis: vistas técnicas para equipas de dados, estruturas tabelares para analistas e resumos para decisão. Em todas elas mantemos ligações de volta às fontes, métricas de qualidade e registos de transformações. Results may vary entre organizações, mas fornecemos instrumentos para medir essa variação e para ajustar modelos, regras e processos à medida que o contexto de research evolui.
Como funcionamos
Informação técnica suficiente para desconfiar com conhecimento de
causa
Antes de pipelines de IA e grafos de entidades, a análise de empresas privadas
dependia de ficheiros partilhados e memória selectiva. Esta página existe para
expor, sem adornos, como trabalhamos hoje na Quoriseltana. Assumimos que os dados são
incompletos, enviesados e difíceis de reconciliar, por isso começamos por mapear
o caos: CRMs antigos, relatórios de terceiros, registos comerciais, notas
internas e apresentações de fundadores. A seguir aplicamos o nosso método de
três camadas, desenhado para research em venture capital e mercados privados:
normalizar formatos e taxonomias, ligar entidades e eventos, e enriquecer com
métricas derivadas, classificações temáticas e anotações de analistas. Cada
passo é documentado com regras explícitas e scores de confiança, para que
equipas possam discutir não só o resultado, mas também o caminho percorrido até
cada número. Results may vary entre clientes, e tratamos essa variabilidade como
sinal de que decisões metodológicas e contextos de dados importam tanto quanto
qualquer modelo de IA.
O que está por trás da nossa abordagem
Na Quoriseltana recusamos a narrativa de que basta “ligar a IA” para que dados privados de
empresas se organizem sozinhos. O que fazemos é mais mundano e, acreditamos, mais útil:
aplicar disciplina estatística e rastreabilidade a informação que já existe, mas está
fragmentada por sistemas, equipas e formatos incompatíveis.
Inventário sem filtros
Começamos por um inventário honesto de fontes: CRMs antigos, bases compradas, registos comerciais, apresentações, notas de reuniões e ficheiros que só vivem em pastas pessoais. A partir daí avaliamos qualidade, sobreposição, lacunas e restrições de uso. Este diagnóstico evita promessas irrealistas e torna explícito o custo real de transformar estes dados em algo utilizável para research em venture capital e mercados privados.
Método em três camadas
Aplicamos o nosso método interno de três camadas: normalizar, ligar, enriquecer. Normalizar significa alinhar identificadores, formatos, moedas, datas e taxonomias sectoriais. Ligar implica reconstruir entidades e relações entre empresas, pessoas e eventos relevantes. Enriquecer é adicionar métricas derivadas, classificações temáticas e anotações estruturadas, sempre com registo de origem e regras de cálculo documentadas.
Outputs auditáveis
Os outputs não são apenas dashboards agradáveis; são tabelas, grafos e documentação
que suportam auditoria. Incluímos scores de confiança, versões de entidade e
histórico de transformações, para que analistas possam verificar, contestar ou
refinar decisões do modelo. Preferimos discussões informadas sobre limites a uma
aceitação acrítica de números aparentemente precisos.
Evolução contínua
Reconhecemos que nenhum pipeline é estático. Revemos modelos, regras de
correspondência e ontologias à medida que o contexto de mercado privado evolui e que
equipas ajustam as suas teses. Results may vary, e parte do nosso trabalho é
explicar por que variam: novas fontes, mudanças regulatórias, critérios internos
revistos ou simples melhoria na qualidade do registo de dados.
Privacidade por design
Desde o desenho inicial consideramos privacidade e enquadramento europeu de
protecção de dados. Limitamos o que recolhemos, definimos finalidades claras e
configuramos acessos por função e projecto. Dados privados de empresas não são
combustível infinito; são activos sensíveis que exigem regras explícitas de
retenção, partilha e anonimização quando apropriado.